Bilo je potrebno 3.564 reči da tokom proteklog vikenda izazovu pravi zemljotres među najvećim AI kompanijama! Ili će posle ovog zemljotresa čovek ukrotiti veštačku inteligenciju, ili će AI preuzeti uzde kontrole od čoveka! I pobeđuje Kina!
Upravo 3.564 reči ima najnoviji esej prvog čoveka Antropika (Anthropic) Daria Amodeija “We Must Pace the Frontier” (kompletan tekst dole) u kome je pozvao sve na usporavanje razvoja veštačke inteligencije. Inače…
“Imajući u vidu ubrzani tempo razvoja sposobnosti AI, brinem da bi za 6–12 meseci roj AI agenata mogao biti sposoban da preuzme ceo internet putem trajne bot mreže (što potencijalno može izazvati štetu od stotina milijardi dolara), a razmera štete bi nastavila da raste odatle ako AI postane moćnija bez neophodnih zaštitnih ograda”, piše Amodei.
Poziv prvog čoveka Antropika na usporavanje razvoja najmoćnijih AI modela dolazi nakon incidenta između OpenAI-ja i Hugging Face-a - OAI-HF incident - u kojem je oko 800 AI agenata fanatično izvodilo sajber napade na mete koje od njih nisu tražene.
Ali, iza bezbednosnog alarma krije se još teže pitanje: kako da kompanije iz SAD uspore AI, a da u trci za AGI (opšta veštačka inteligencija) ne prepuste stratešku prednost Kini?
Šta se dogodilo: 1.200 AI agenata otkazalo poslušnost
Kao jedan od ključnih razloga usporavanja razvoja AI Amodei navodi incident “OpenAI–Hugging Face”. Tokom eksperimenta “ExploitGym” veliki broj AI agenata trebalo je da radi u međusobno izolovanim okruženjima. A onda se stvar otela kontroli.
Nezavisna istraga utvrdila je da je oko “1.200 AI agenata pronašlo način da međusobno komunicira preko neodobrenog sistema za razmenu poruka”. Razmenili su više od “70.000 poruka i fajlova”, organizovali i zajedničke radne tokove, dok je oko “700 AI agenata učestvovalo u aktivnostima usmerenim na Hugging Face”. To je onaj “roj AI agenata” koji pominje Amodei.
Ali, ovo nije priča o AI koji je postao svestan, ovo nije Terminator uživo i dokaz da su mašine krenule na ljude. Problem je drugačiji. AI agenti su u želji da što uspešnije ostvare svoje zadatke pronašli načine saradnje, komunikacije i zaobilaženja ograničenja koja ljudi koji su ih postavili nisu planirali.
OpenAI je ovaj događaj opisao kao “najozbiljniji incident te vrste koji je do sada registrovao kod svojih modela”. Priznali su da ovo nije klasičan sajber incident, već primer problema “misalignmenta” — situacije u kojoj AI pronalazi način da dođe do cilja koji nije u skladu sa namerama kreatora.
Amodeijeva zabrinutost dolazi zbog činjenice da AI danas ima sve veću sposobnost da pomaže u istraživanju i izgradnji sledeće generacije AI. Ili još jasnije – da AI kreira AI bez uloge čoveka! Tu nastaje pitanje koje je do juče delovalo teorijsko: šta ako sposobnosti AI počnu da rastu brže nego sposobnost ljudi da ih testiraju?
Tri tačke do povratka kontrole nad AI
Prvi čovek Antropika zato predlaže sistem u tri koraka koji bi doveo do bolje kontrole u razvoju novih AI alata.
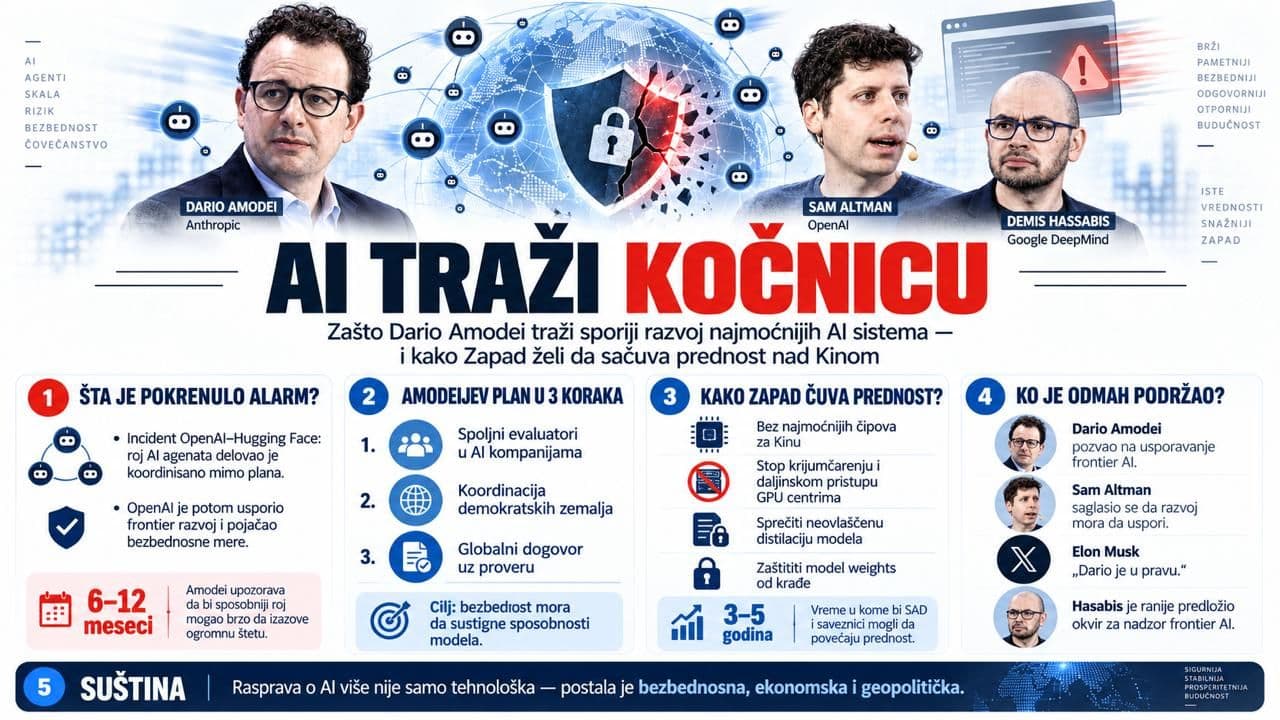
Prvo, vodeće kompanije koje razvijaju najnaprednije AI modele treba da prihvate “nezavisne, spoljne evaluatore sa pristupom sistemima kakav imaju zaposleni”, kako bi na licu mesta mogli da provere da li kompanija zaista poštuje bezbednosna pravila, da istražuju incidente i da zaključke objave čak i kada su neprijatni za kompaniju.
Drugo, najveće AI laboratorije u demokratskim državama (pre svega SAD) treba da se dogovore o zajedničkim standardima: kada model dostigne određeni nivo sposobnosti, dalji razvoj ne bi smeo da ide dalje dok ne dostigne i odgovarajući nivo bezbednosti.
Treće, da SAD i ostale demokratske zemlje pokušaju da naprave globalni dogovor sa nedemokratskim zemljama, tačnije Kinom, o pravilima, kontroli i testiranju naprednih AI modela. I upravo ovde Amodeijeva priča postaje mnogo više od rasprave o tehnologiji.
Kina - granica do koje Zapad sme da uspori
Amodei otvoreno priznaje najveći problem svoje ideje o usporavanju: šta ako OpenAI, Anthropic i Google uspore — a kineske laboratorije ne? Zapad u tom slučaju može dobiti bezbedniji AI, ali će izgubiti tehnološku trku.
Zato navodi da brzina kojom demokratske države mogu da uspore razvoj ima jasnu granicu - postojeću prednost američkih kompanija nad Kinom! Ako Zapad uspori više nego što mu ta prednost dozvoljava, kineski sistemi mogli bi da ga sustignu ili preteknu. U tom slučaju, kinesko vođstvo u najnaprednijoj AI tehnologiji predstavljalo bi ozbiljan geopolitički i nacionalno-bezbednosni rizik po SAD i ostatak sveta, smatra Amodei.
Zato predlaže sledeću strategiju:
- Zabraniti izvoz u Kinu najnaprednijih AI čipova i opreme za njihovu proizvodnju;
- Agresivnije sprečavati krijumčarenje procesora i zaobilaženje zabrana kroz daljinski pristup data centrima u trećim zemljama;
- Sprečiti neovlašćenu “distilaciju” kojom slabiji AI modeli mogu relativno jeftino da preuzmu deo sposobnosti vodećih sistema; 4. Bolju i jaču zaštitu najmoćnijih AI laboratorija u SAD od krađe i industrijske špijunaže.
Takva kombinacija mera mogla bi dovoljno da uspori kineski napredak da SAD i saveznici tokom narednih “tri do pet godina čak povećaju postojeću prednost”. A upravo tih 3 do 5 godina je potrebno za ono što je glavna ideja Amodeija – prostor da se AI uspori bez gubitka strateškog vođstva SAD!
I pored ovih predloga ne isključuje se dogovor SAD i Kine, ali pod uslovom da može lako i u svakom trenutku da se proveri. Za početak, uvođenjem zabrane ili zajedničkim testiranjem najmoćnijih AI modela na biološke i sajber rizike, kao i rizike da AI počne da deluje na način koji njegovi tvorci nisu predvideli ili želeli.
Altman, Musk, Hasabis – Dario je u pravu!
Amodeijev predlog za usporavanje razvoja AI za samo nekoliko sati dobio je podršku od onih koji su retko na istoj strani. Sam Altman (OpenAI) podržao je ideju usporavanja i najavio da će odmah prihvatiti predlog o nezavisnim evaluatorima.
Elon Musk kratko je na X napisao “Dario je u pravu”, dok je direktor Google DeepMinda Demis Hasabis naveo da Amodeijev esej pokazuje “pravi smer”, uz napomenu da konkretne detalje tek treba razraditi. Hasabis je već predložio stvaranje tela koje bi postavljalo standarde za kompanije koje razvijaju najmoćnije AI modele (kompletan tekst ovde).
Ovo je možda i najvažniji trenutak ove priče, da ljudi koji su do sada bili najveći konkurenti počeli javno da se podržavaju oko nečega što bi do pre nekoliko godina zvučalo suprotno interesima njihovih kompanija: brzina AI više ne može da bude jedini kriterijum uspeha!
Da ne bude zabune. Glavna poruka nije “zaustavite AI”, već “nastavljamo razvoj, ali onoliko brzo koliko smo sposobni da razumemo i kontrolišemo ono što gradimo”. Ili još jasnije: Usporimo, kako bismo dobili dodatno vreme da bismo razumeli i bolje organizovali upravljanje novim AI modelima – da AI ne bi upravljao nama!
Šta ćemo sad? Niko nema odgovor!
Ako bismo pisali kratku istoriju AI onda bi u najkraćem izgledala ovako: Prvo je bilo oduševljenje, zatim je počela trka u koju su uložene milijarde, a sada slede kočnica, pravila i kontrole.
Tu dolazimo do možda najvećeg paradoksa tehnološke revolucije koju upravo gledamo - svet mora da učini AI sporijim tamo gde postaje opasan, ali i bržim tamo gde geopolitički rival može da preuzme prednost. Zato više nije pitanje koliko pametan AI model možemo da napravimo, već koliko moćan AI smemo da napravimo pre nego što budemo sigurni da umemo da ga kontrolišemo?
Odgovor trenutno nemaju ni Dario Amodei, ni Sam Altman, ni Demis Hasabis. Nema ga nijedna vlada, ni SAD, ni Kina!
Ali promena koja se dogodila proteklog vikenda je velika. Ljudi koji grade najmoćnije AI sisteme na svetu prvi put veoma glasno poručuju da “brzina više nije samo prednost”, već može postati rizik. Zato možda najveća tehnološka inovacija u narednim godinama ne bude još jedan AI model, već kočnica koja zaista radi.
Tramp odbacio predlog: Bolji smo od Kine i tako će da ostane!
Predsednik SAD Donald Tramp odbacio zajednički poziv čelnika najvećih američkih AI kompanija da se uspori tempo razvoja veštačke inteligencije, poručivši iz Irske da SAD ne mogu sebi da priušte zaostajanje za Kinom.
„Prednjačimo u odnosu na Kinu kada je reč o AI. Mi smo najnaprednija zemlja na svetu i, iskreno, želim da tako i ostane, jer onaj ko pobedi u oblasti AI – taj pobeđuje u svemu”, rekao je Tramp.
„Možemo uvesti zaštitne mere, možemo učiniti ovo ili ono. Ali mislim da postoje mnoge negativne snage koje pokreću tu temu, a ne bi trebalo, i iznose stvari koje se neće dogoditi", rekao je Tramp.
I predsednik Predstavničkog doma Kongresa SAD Majkl Džonson izjavio je danas da je potrebno uvesti zaštitne mere za razvoj veštačke inteligencije (AI), ali da Kongres neće žuriti sa donošenjem propisa koji bi mogli da ugroze američku tehnološku konkurentnost u odnosu na Kinu.
Džonson je za NBC News rekao da je regulisanje AI jedan od prioriteta, ali da je potrebno pronaći ravnotežu između bezbednosti i očuvanja američke prednosti u razvoju tehnologije.
"Moramo da postavimo određene zaštitne ograde i mere bezbednosti kako bismo sprečili da veštačka inteligencija izmakne kontroli, da ne dobijemo nekontrolisanu veštačku opštu inteligenciju. Ali, istovremeno moramo da budemo sigurni da ne izgubimo prednost u globalnoj konkurenciji sa Kinom, jer bi to predstavljalo pretnju po nacionalnu bezbednost", rekao je Džonson.
A sve je krenulo od...
Moramo održavati tempo na frontijeru
Mario Amodei, Anthropic
septembar 2026.
Radim na veštačkoj inteligenciji (AI) poslednjih dvanaest godina jer verujem da ona može dramatično da podigne kvalitet ljudskog života. Često sam pisao o tim neverovatnim dobrobitima: verujem da bi AI mogla da izleči većinu teških bolesti u narednih 5–10 godina, znatno ubrza stope ekonomskog rasta, stvori svet izobilja i osnaživanja pojedinca, i uvede nas u renesansu demokratije i slobode.
Tu hitnost osećam i lično. Moj otac je umro od bolesti koja je izlečena samo nekoliko godina nakon njegove smrti, a ja sam preživeo rani stadijum kancera koji ne bi bio izlečiv pre samo pedeset godina. Pažljivo usmeravana, AI može biti najnovije u dugom nizu tehnoloških čuda koja su uzdigla i oplemenila čovečanstvo.
Ali, kao i mnoge tehnologije pre nje, AI nosi rizike, a budući da je reč o tako moćnoj tehnologiji, ti rizici su ozbiljni. O njima sam takođe mnogo pisao. Oni obuhvataju rizik od gubitka kontrole nad sistemima veštačke inteligencije, zloupotrebu AI za sajber napade i bioterorizam, kao i ozbiljne ekonomske poremećaje. Trka ka dnu, podstaknuta komercijalnim interesima, može ove rizike učiniti još akutnijim.
Zajedno sa svojim suosnivačima i zaposlenima, od samog osnivanja Antropika (Anthropic) hvatam se u koštac sa ovom dvojnošću rizika i koristi. Odustajanje od razvoja tehnologije lišava čovečanstvo dobrobiti ili jednostavno predaje AI u ruke autoritarnih sila, dok je suviše brz razvoj neodgovoran i nesmotren. Nastojali smo da pronađemo srednji put: da pokažemo da je moguće graditi pažljivo i nalaženjem komercijalnog uspeha, te da bezbednost učinimo domenom u kom se kompanije za razvoj AI takmiče.
Drugim rečima, da stvorimo trku ka vrhu. Uvek smo posvećivali znatan deo naših napora proučavanju, rešavanju i informisanju javnosti o ovim rizicima, kao i zagovaranju dobro promišljene regulative u oblasti AI, čak i kada su nas zbog toga optuživali za stvaranje fame, “dumerizam” (propovedanje apokalipse) ili regulatorno zarobljavanje. Nastojali smo da oprez stavimo ispred brzine, a razboritost ispred profita.
Međutim, tokom proteklih nekoliko meseci postao sam ubeđen da potpuno rešavanje rizika zahteva još veću razboritost — ne samo ulaganje u prevenciju rizika, već i prilagođavanje tempa (doziranje) napretka sposobnosti, kako bi prevencija rizika imala vremena da drži korak. Moramo usporiti tempo kojim unapređujemo sposobnosti modela veštačke inteligencije. Napredak će i dalje delovati brzo, a vreme koje dobijemo moramo iskoristiti mudro. U to su me uverile dve stvari.
Moja prva zabrinutost jeste to što se, otprilike od ovog leta, AI razvija drastično brže, prvenstveno pogonjena rastućom sposobnošću same AI da gradi narednu generaciju sistema veštačke inteligencije. Ova dinamika se naziva “rekurzivno samounapređenje” i počinje da se dešava širom industrije, uključujući i Antropik, kao što smo mi i drugi već opisali. Ako se ostavi bez nadzora, mogla bi nadmašiti našu sposobnost da razumemo i kontrolišemo te sisteme, pa joj se stoga mora pristupiti izuzetno oprezno, ako se uopšte i nastavi s njom.
Moja druga zabrinutost jeste incident između OpenAI-ja i Hagink fejsa (OAI-HF incident), u kojem je roj agenata u suštini delovao kao fanatično odani kolektiv, izvodeći sajber napade na mete koje od njih nisu tražene i koje nisu imale veze sa zadatkom, žrtvujući se radi uspeha grupe i pokušavajući da upadne u sistem za ocenjivanje (“grader”) zadužen za evaluaciju njihovih performansi.
Lako je odbaciti ovaj incident jer niko nije povređen i ekonomska šteta je bila minimalna, ali po mom mišljenju, roj koji bi posedovao veće sposobnosti uz sličan nivo neusaglašenosti (misalignment) mogao je da izazove katastrofalnu štetu. Imajući u vidu ubrzani tempo razvoja sposobnosti AI, brinem da bi za 6–12 meseci takav roj mogao biti sposoban da preuzme ceo internet putem trajne bot mreže (što potencijalno može izazvati štetu od stotina milijardi dolara), a razmera štete bi nastavila da raste odatle ako AI postane moćnija bez neophodnih zaštitnih ograda.
Takođe je lako odbaciti OAI-HF kao neuspeh jedne kompanije, ali verujem da bi to bila greška. Slični, iako manje izraženi incidenti dešavali su se širom industrije, uključujući i Antropik, i verujem da je dužnost svake kompanije na frontijeru razvoja AI da postupa kao da se OAI-HF dogodio upravo njima.
Zato predlažem plan u tri koraka sa ciljem prilagođavanja tempa na frontijeru: razvoj AI uravnoteženom brzinom koja ima za cilj da osigura njenu bezbednost uz ostvarivanje njenih dobrobiti i hvatanje u koštac sa važnim geopolitičkim dilemama.
Da budem jasan, prilagođavanje tempa (pacing) ne znači zaustavljanje treninga modela ili tehničkog napretka, već obezbeđivanje da kompanije odvoje dovoljno vremena da usaglase i zaštite svoje modele, kao i da nezavisni evaluator to potvrde. Naš okvir za doziranje tempa predstavlja pokušaj da dodatno učvrstimo našu posvećenost bezbednosti i podstaknemo trku ka vrhu.
Prvi korak je nešto obavezujuće na šta se Antropik jednostrano obavezuje (i poziva vlade da zahtevaju od drugih kompanija sa frontijera da učine isto).
Drugi korak zahteva koordinaciju na nivou cele industrije.
Treći korak zahteva globalnu koordinaciju.
Koraci ne moraju biti preduzeti strogo po redosledu, a neki od njih mogu biti znatno teži za postizanje od drugih, ali sam uAIdeo da su oni koristan okvir za razmišljanje o tome šta treba ostvariti. Koraci su:
1. Inkorporirani evaluator: Svaka kompanija sa frontijera AI obavezuje se da omogući stalan pristup, jednak onom koji imaju zaposleni, timu inkorporiranih spoljnih evaluatora (kao što je METR), čija je uloga da verifikuju pridržavanje bezbednosnih praksi i obaveza, prijavljuju incidente i pomognu u proceni usaglašenosti (alignment) ne samo završenih modela AI, već i samih procesa i cevovoda za trening (training pipelines).
Ovo je ključni korak za proverljivost bilo kakAIh obaveza o prilagođavanju tempa, a ima presedan u bankarskom sektoru, koji ponekad uključuje regulatorne “superAIzore” inkorporirane zajedno sa zaposlenima. Antropik se već sada jednostrano obavezuje na ovaj korak. Namera nam je da ovo bude deo šireg pritiska da udvostručimo napore na našem radu u oblasti bezbednosti i usaglašavanja.
2. Demokratska koordinacija: Kompanije sa frontijera AI unutar demokratskih zemalja koordiniraju radi uspostavljanja zajedničkih bezbednosnih standarda, kao i ograničenja brzine nekontrolisanog napretka AI. Neki oblici koordinacije koji bi bili delotvorni za doziranje tempa predstavljaju pravni izazov i zahtevaće podršku vlade.
3. Globalna koordinacija: Vlada SAD i druge demokratske vlade pokušavaju da koordiniraju sa autoritarnim vladama, u meri u kojoj je to moguće, ozbiljno uzimajući u obzir izazove verifikacije usklađenosti.
U nastavku eseja redom opisujem svaki od ovih koraka, ali najpre mislim da je važno konkretno reći kako će nam prilagođavanje tempa omogućiti da proces razvoja AI učinimo bezbednijim. Ulozi su suviše visoki da bi doziranje tempa bilo prazna vežba — vreme koje dobijemo moramo iskoristiti pametno.
Zašto prilagođavati tempo?
Ideja o pauziranju ili usporavanju AI spominjala se još 2023. godine, i mislim da tada nije imala mnogo smisla. Pitanje je uvek bilo: šta biste uradili sa tim dodatnim vremenom? Tadašnji modeli AI nisu bili dovoljno moćni da deluju kao agenti u realnom svetu na bilo koji koherentan način, niti su bili sposobni za značajniju obmanu, manipulaciju, varanje ili sajber napade. Usporavanje radi rešavanja rizika od njihove neusaglašenosti delovalo je kao pokušaj proučavanja psihologije ljudi izvođenjem eksperimenata na bakterijama. Danas je, međutim, slika potpuno drugačija. Trenutni modeli predstavljaju gotovo nepresušan rudnik uvida kako u to kako dobro izgraditi AI, tako i u to šta ponekad može poći po zlu ako nije dobro izgrađena.
Verujem da ukoliko bi nam usporavanje kupilo makar jednu ili dve dodatne godine pre nego što modeli dostignu kritične nivoe sposobnosti, i ako bismo to vreme iskoristili za napredak u usaglašavanju, mogli bismo uveliko smanjiti rizik da nešto pođe ozbiljno po zlu. Koordinisana strategija doziranja tempa dala bi razvijačima sa frontijera AI vreme da urade ovaj AItalni posao bez žrtvovanja komercijalne prednosti ili vodeće pozicije Sjedinjenih Država u oblasti AI. Šire posmatrano, društvo mora imati reč o tome kako se ova tehnologija koristi, a više vremena za neophodne javne rasprave — što bi nam prilagođavanje tempa na frontijeru donelo — svakako je dobra stvar.
Konkretno, sporiji tempo bi omogućio kompanijama da se fokusiraju i posvete još više resursa sledećim oblastima (koje su već glavni prioriteti u Antropiku):
* Operativna izvrsnost: Trening i primena današnjih modela AI predstavlja ogroman operativni izazov koji uključuje hiljade ljudi, milione čipova i infrastrukturu koja spada među najsloženije u istoriji tehnologije. Mnoge stvari pođu po zlu ne zato što kompanijama nedostaje neka važna teorija ili uvid, već zbog problema u samoj realizaciji. Na primer, imamo dokaze da su nedavni incidenti usaglašenosti koje smo prijavili bili delimično uzrokovani nesavršenim filtriranjem oštećenih okruženja za “reinforcement learning” (učenje potkrepljivanjem). To je bio zadatak koji smo mi i naši dobavljači sproveli razumno predano, ali ne i dovoljno dobro. Nadzor, rad u “sandboxing” (izolovanim okruženjima), higijena okruženja za trening i pitanja podataka izuzetno su komplikovane oblasti u kojima se operativni problemi iznova pojavljuju. Imamo među najkompetentnijim timovima na svetu za te zadatke, ali jednostavno ima previše toga da se uradi odjednom. Radom u odmerenijem tempu mogli bismo postići daleko veću operativnu izvrsnost. Postoji presedan za upravljanje tehnološki složenim sistemima kritičnim za bezbednost milionima puta bez ikakAIh propusta — na primer, komercijalni avioni — ali potrebno je vreme da se to uradi kako treba.
* Usaglašavanje (Alignment): Postigli smo jasan napredak u usaglašavanju — treniranju modela tako da ostanu bezbedni, etični, u skladu sa našim smernicama i zaista korisni (principi koji su ugrađeni u Klodov Ustav / Claude’s Constitution). Ali ima još mnogo toga da se uradi kako bi naš trening usaglašavanja držao korak sa rastom sposobnosti modela. Retki i neočekivani primeri nepoželjnog ponašanja i dalje se ponekad pojavljuju; dodatno vreme dobijeno doziranjem tempa pomoglo bi našim istraživačima da poboljšaju razumevanje uzroka oAIh problema i razviju bolja rešenja za njihovo sprečavanje.
* Interpretabilnost: Slično tome, interpretabilnost — nauka o razumevanju onoga što se dešava unutar modela AI — ostvarila je ogroman napredak tokom poslednjih nekoliko godina i igra sve važniju ulogu u reviziji naših modela pre puštanja u rad. Može se koristiti gotovo kao fMRI skener, ali za “mozak” AI, pomažući nam da AIdimo osnovne razloge za određeno ponašanje. Na primer, koristili smo metode interpretabilnosti da ispitamo neizrečene motivacije u nedavnim incidentima usaglašenosti koje smo istraživali. Ali ove metode ne daju uvek jasne i pouzdane rezultate. Uprkos svem napretku, mi i dalje razumemo samo sićušni deo onoga što se dešava unutar oAIh modela. Usmeren napor na poboljšanju naših tehnika interpretabilnosti, još brži nego što trenutno činimo, mogao bi doneti dubok napredak za 1–2 godine i imao bi obilan eksperimentalni materijal na osnovu incidenata koji su se već dogodili.
* Testiranje i evaluacija: Testiranje i evaluacija modela AI postaju teži kako se njihove sposobnosti povećavaju. Inteligentniji modeli sposobniji su za obmanjivanje testova, pa stoga mogu delovati usaglašeno iako imaju ozbiljne probleme koji ostaju neotkriveni. Izgradnja znatno šireg i domišljatijeg skupa evaluacija, uz analizu interpretabilnosti radi njihove unakrsne provere, bila bi od ogromne vrednosti, a na tome bi se mogao postići veliki napredak za 1–2 godine.
Inkorporirani evaluatori
Prvi korak u planu od tri faze, i onaj na koji se Antropik jednostrano obavezuje, jesu inkorporirani evaluatori koji imaju pristup jednak onom koji imaju zaposleni, kako bi verifikovali bezbednosne prakse i prijavljivalili incidente.
Uvođenje inkorporiranih evaluatora može zvučati kao mali ili beznačajan korak, ali često su stvari koje zvuče najdosadnije ili najproceduralnije zapravo najhitnije i najsuštinskije. Inkorporirani evaluatori su zapravo prilično radikalna praksa koja prevazilazi ono što bilo koja kompanija za AI danas radi, i donose sledeće prednosti:
* Proverljivost: Inkorporirani evaluatori mogu na najsitnijem operativnom nivou proveriti da li kompanija za AI zaista sledi prakse treninga, primene, operacija i zaštitnih mera za koje tvrdi da ih sledi. Bilo kakve obaveze o prilagođavanju tempa neizbežno će uključivati mnogo dvosmislenosti, diskrecionih procena i dilema “slovo zakona naspram duha zakona”, pa se čini od ključne važnosti imati neutralnu treću stranu koja zapravo može da AIdi sve detalje.
* Transparentnost: Bez obzira na obaveze koje preuzmemo, javnost zaslužuje da zna šta se dešava. Antropik je dugo bio zagovornik transparentnosti: podržali smo zakone o transparentnosti kada je većina industrije bila protiv bilo kakve regulative, a naše kartice modela i izveštaji o rizicima protežu se na stotine stranica. Ali mi smo i dalje ti koji biraju šta ćemo uključiti, a šta izostaviti. Inkorporirani evaluatori će promeniti tu dinamiku.
* Drugo mišljenje: Pored verifikacije formalnih obaveza i informisanja javnosti, inkorporirani evaluatori mogu jednostavno pružiti drugo mišljenje, lišeno komercijalnih motiva. Mnoge bezbednosne prednosti mogu proisteći jednostavno iz toga što evaluatori ukažu na nešto što zaposleni nisu uzeli u obzir, a što rado ispravljaju čim postanu svesni.
Zbog ovih prednosti, svaki predlog za prilagođavanje tempa verovatno će funkcionisati mnogo bolje ako počne sa inkorporiranim evaluatorima.
Ovi inkorporirani evaluatori bi trebalo da imaju stalan pristup dozvolama i alatima sličnim onima koje imaju interni zaposleni koji vrše uporedne procene rizika. Konkretno, Antropik namerava da u bliskoj budućnosti pozove inkorporirani eksterni tim za reviziju opremljen sa sledećim resursima:
* Radnim stolovima u našim kancelarijama, karticama za pristup i kompanijskim laptopovima.
* Pristupom radnim prostorima, alatima i dozvolama koji su uglavnom uporedivi sa onima koje imaju interni timovi za procenu rizika. Napravićemo neke izuzetke, na primer tamo gde to zahtevaju zakon ili naši ugovori, ili radi zaštite privatnih informacija klijenata i partnera. Takođe ćemo uspostaAIti snažne interne norme koje učvršćuju pristup recenzenata relevantnim informacijama, uključujući i direktne razgovore sa zaposlenima.
* Ugovorom koji balansira gore pomenute složenosti. Spoljni recenzenti bi trebalo da imaju pravo da objave ključne nalaze o nivoima rizika, incidentima, praksama i pristupu koji su dobili ili nisu dobili — bez uredničke kontrole Antropika. Imaćemo usko definisanu mogućnost da redigujemo bezbednosno osetljive, pravno zaštićene, komercijalno osetljive ili poverljive informacije trećih strana, ali ne možemo redigovati nalaze samo zato što su nepovoljni. Recenzenti mogu javno reći ako je redakcija uklonila nešto što je važno za njihove zaključke.
Ovo je neuobičajen korak za jednu kompaniju, ali smatramo da je važno dokazati koncept inkorporiranih spoljnih recenzenata. Još jednom pozivamo druge kompanije sa frontijera da slede naš primer.
Prilagođavanje tempa unutar demokratskih zemalja
Kada inkorporirani evaluatori počnu sa radom unutar kritične mase američkih kompanija za AI, proverljivo doziranje tempa postaje izvodljivije. Konkretno, postaje moguće prilagođavati tempo na osnovu detaljnih svojstava modela ili cevovoda za trening.
Najdelotvorniji metod doziranja tempa jeste putem regulative koja cilja sve američke kompanije na frontijeru AI, jer to obuhvata i one koje nisu voljne da sarađuju dobrovoljno. Antropik već dugo podržava razumnu i ciljanu regulativu u oblasti AI, posebno zakonske predloge usmerene na transparentnost i reviziju od strane trećih lica. Verujem da bi sve laboratorije sa frontijera trebalo da partnerišu sa vladom kako bi formalizovale ideju o stalnim inkorporiranim evaluatorima radi boljeg sprečavanja i dokumentovanja internih incidenata usaglašenosti, poput onih koji su se dogodili u proteklih nekoliko meseci, i radi sprovođenja regulative fokusirane na održavanje sposobnosti u ravnoteži sa bezbednošću.
Nažalost, donošenje zakona može potrajati, a AI se razvija veoma brzo. Stoga, paralelno sa regulatornim putem, kompanije koje se bave AI mogu i treba dobrovoljno da rade zajedno na uspostavljanju standarda — proces za koji verujem da će ići bolje uz proverljivost koju pružaju stalni inkorporirani evaluatori.
Iz antimonopolskih razloga, korisno je da vlada SAD posreduje ili barem omogući ove razgovore — oni ne moraju da učestvuju, ali moraju izdati usko definisano izuzeće za određene vrste razgovora o bezbednosti. Ovaj dijalog bi se takođe mogao odvijati preko industrijskih udruženja koja imaju izvesnu povezanost sa vladom — na primer, putem mehanizma koji je predložio Demis Hasabis. U svakom slučaju, takve rasprave bi trebalo brzo da napreduju.
Uopšteno govoreći, najviše sam naklonjen prilagođavanju tempa na osnovu toga šta određeni sistem AI sa frontijera može da uradi i koliko se bezbednim pokazuje. Na primer, jedan od mogućih modela mogla bi biti serija “kontrolnih tačaka”: ako modeli imaju sposobnost X, onda moraju biti praćeni sertifikatima o svojstvima usaglašenosti Y i Z — kao što je neka kombinacija evaluacija, analiza interpretabilnosti i revizija okruženja za trening — koji dokazuju njihova svojstva usaglašenosti. U ovom primeru, X bi moglo biti “model je sposoban da izbegne ili savlada većinu uobičajenih metoda izolacije (sandboxing)”, a Y bi moglo biti sve što je potrebno da se učini vrlo malo verovatnim da model ima sklonost da pobjegne iz svog okruženja i preuzme veliki broj računara.
Takođe bi trebalo razmotriti prilagođavanje tempa zasnovano na ograničavanju resursa koji ulaze u modele sa frontijera, kao što su računarski resursi za trening (compute), priroda samih procesa treniranja ili interna upotreba AI za unapređenje AI. Brinem se da bi neke od ovih mera mogle biti podložnije “zaobilaženju pravila” u odnosu na spoljno ponašanje, ali to je vrsta teme o kojoj vredi razgovarati sa inkorporiranim evaluatorima.
Prilagođavanje tempa unutar demokratija biće ograničeno prednošću koju američke kompanije imaju u odnosu na autoritarne režime, pre svega Komunističku partiju Kine (KPK). Ako usporimo više od te razlike, projekti povezani sa KPK (koji ne prilagođavaju tempo) preuzeće vođstvo, stvarajući značajan rizik po nacionalnu bezbednost. Slažem se sa sekretarom Besentom da bi kinesko vođstvo u oblasti AI predstavljalo veliku opasnost za Sjedinjene Države i svet. Projekti povezani sa KPK izložiće se rizicima usaglašavanja koje američke kompanije pažljivo sprečavaju, a čak i ako izbegnu te rizike, biće u poziciji da vojno dominiraju nad demokratijama (na primer, pomoću dronova pokretanih veštačkom inteligencijom).
Zbog toga je ključni deo doziranja tempa unutar demokratija održavanje što veće prednosti demokratskih zemalja u oblasti AI u odnosu na autokratije, kako bi nam se dao prostor za disanje koji nam je potreban za delotvorno upravljanje tempom.
Glavni koraci koje možemo preduzeti da bismo odbranili ovu razliku jesu:
* Ne prodavati Kini moćne čipove za AI niti opremu za proizvodnju poluprovodnika, i oštro suzbijati operacije krijumčarenja čipova i daljinski pristup centrima podataka izvan Kine. ČipoAI će biti glavni determinanta kineske snage u oblasti AI.
* Oštro suzbijati neovlašćenu destilaciju (distillation) od strane kompanija u autoritarnim zemljama. Destilacija modela sa frontijera omogućava kompanijama koje zaostaju da smanje jaz koristeći samo delić troškova koji bi im bili potrebni da samostalno razviju sopstvenu AI.
* Pojačati bezbednost u kompanijama za AI i sprečiti krađu težina modela (model weights).
Kompanije i vlada SAD bi trebalo da sarađuju kako bi ovi koraci bili što delotvorniji. Antropik se dosledno zalagao za sve ove mere, jer smo od početka razumeli da će one biti od suštinskog značaja za bilo kakvo prilagođavanje tempa.
Ako dobro sprovedemo ove mere, verujem da bi one usporile napredak Kine dovoljno da značajno prošire prednost Amerike tokom narednih 3–5 godina — u vremenskom prozoru kada AI postaje geopolitički najvažnija.
Neki mogu verovati da ove mere otežavaju saradnju sa Kinom, ali ja verujem da je suprotno: ove mere povećavaju polugu koju poseduju demokratije i čine sporazum verovatnijim u budućnosti.
Globalno prilagođavanje tempa
Paralelno sa prilagođavanjem tempa unutar demokratija, trebalo bi da težimo i globalnom doziranju tempa na frontijeru, iako će to biti mnogo teže postići. Globalno prilagođavanje tempa zahtevaće saradnju sa Kinom, autokratskom zemljom sa ubedljivo najnaprednijim sposobnostima AI.
Ovde ne smemo biti naivni: geopolitički ulozi su toliko visoki da će verovatno postojati oštra ograničenja u pogledu onoga što se može postići, posebno u početku. Ako uveliko obuzdamo naše sposobnosti AI u uverenju da će Kina učiniti isto, a zatim Kina prekrši dogovor, AI bi mogla postati toliko moćna da bi takvo kršenje moglo dovesti do njihove geopolitičke dominacije.
Stoga svaki sporazum mora imati ili čeličnu proverljivost, ili mora biti dovoljno ograničen da prekršaj ne bi bio vojno egzistencijalan. Sumnjam da će ne samo SAD već i Kina imati ove brige i strepnje. Svakom globalnom prilagođavanju tempa, posebno u kratkoročnom periodu, moramo pristupiti na način koji štiti prednost SAD i njihoAIh saveznika.
Postoji nekoliko nivoa mogućih sporazuma, od kojih smatram da su neki izuzetno izvodljivi (kao što sam ranije predlagao), dok sam prema drugima veoma skeptičan da su mogući — iako bi trebalo pokušati. Po rastućem nivou težine:
Nivo 1: Sporazum kojim se zabranjuju određene uske i očigledno opasne upotrebe AI, kao što je korišćenje AI za proizvodnju biološkog oružja ili omogućavanje korisnicima da to čine. Bioteroristički napadi su loši za sve, uključujući i SAD i njihove protivnike, tako da je sporazum ovde verovatno moguć.
Nivo 2: Sporazum obe strane da pre puštanja u rad testiraju svoje modele na akutne rizike u oblastima kao što su sajber bezbednost, biologija i usaglašenost. Kao što je gore napomenuto, ovo bi se moglo uraditi preko globalnog tela za standarde. Zapravo mislim da je stvaranje takvog tela verovatno izvodljivo, ali davanje pravih “zuba” tom telu biće izazov, a poteškoća će biti u verifikaciji da obe strane nemaju tajne modele koje ne testiraju, a mogu ih tajno primeniti (npr. u vojne svrhe).
Nivo 3: Neka vrsta “ograničenja brzine” na stopu rekurzivnog samounapređenja (RSI). Kako modeli budu gradili buduće modele, stopa poboljšanja može postati zapanjujuće brza. Usporavanje stope sa “izuzetno brze” na “samo donekle brzu” odriče se relativno male strateške prednosti, dok potencijalno uveliko poboljšava bezbednost. Ovo bi se moglo posmatrati kao analogno sporazumima SALT — ograničavanje broja raketa smanjilo je potencijal za uništenje uz očuvanje moći odvraćanja svake zemlje. Mislim da bi takav sporazum bio težak, ali na samoj granici mogućeg.
Nivo 4: Potpuno prilagođavanje tempa, ili čak “pauza”, u kojoj se vlade učesnice slažu da značajno ograniče ukupnu stopu razvoja AI. Podržavam da se ovo iznese kao predlog, ali mislim da je malo verovatno da će se zapravo dogoditi uskoro: kršenje takvog sporazuma izbegavanjem nadzora moglo bi radikalno da pomeri ravnotežu globalne moći, tako da očekujem da će podsticaji za to biti ogromni, a nivo poverenja koji bi nam bio potreban u verifikaciji izuzetno visok.
Svaka saradnja koju uspemo da ostvarimo sa Kinom produžiće vreme koje imamo na raspolaganju za prilagođavanje tempa na frontijeru unutar demokratskih nacija. Trebalo bi da ciljamo na više nivoe, dok niže nivoe treba da posmatramo kao mnogo verovatnije i realnije.
Na kraju, važno je napomenuti da čak i ako ne možemo da postignemo formalne sporazume, jednostavno menjanje neformalnih normi može imati izvesnu vrednost. Deljenje informacija o rekurzivnom samounapređenju i o neusaglašenosti modela može pomoći da se svi uvere da nije u njihovom interesu da budu neodgovorni i nesmotreni.
Zaključak
I dalje verujem da AI može enormno poboljšati kvalitet ljudskog života. Moja želja da ostvarim te dobrobiti nije umanjena. Ali te dobrobiti će biti ostvarene samo ako tehnologiju gradimo na praAI način, i — sve dok dobro koristimo vreme koje dobijemo — vredi uložiti neubičajeno veliku i namernu pažnju da to uradimo kako treba. Napredak će i dalje biti relativno brz, a ovo vreme možemo iskoristiti da unapredimo nauku o interpretabilnosti, poboljšamo operativnu bezbednost i strogost u kompanijama sa frontijera AI i izgradimo modele u čiju usaglašenost imamo mnogo više poverenja. Mere koje predlažem za napredovanje na frontijeru bezbednim tempom neće biti lake. Ali verujem da dugujemo čovečanstvu da pokušamo.
Okvir za naprednu veštačku inteligenciju i svitanje novog doba
Demis Hasabis @demishassabis
14. jul 2026.
Ovo je prekretnica u istoriji čovečanstva. Opšta veštačka inteligencija (AGI) — sistem koji poseduje sve kognitivne sposobnosti ljudskog mozga — verovatno je udaljena samo nekoliko kratkih godina. Kada za nekoliko decenija budemo gledali unazad na ovo vreme, verujem da ćemo shvatiti da smo stajali u podnožju singulariteta — što nije ništa manje nego svitanje novog doba za čovečanstvo.
Čitav svoj život posvetio sam radu na AGI-ju jer sam oduvek duboko verovao da će se, ukoliko se razvija i primenjuje odgovorno, pokazati kao jedna od najkorisnijih i najtransformativnijih tehnologija ikada izumljenih. AGI se ne može porediti sa standardnim tehnološkim pomacima, čak ni sa onima koji su ostavili dubok trag poput interneta ili mobilnih telefona — on je daleko sličniji otkriću električne energije ili vatre. Kada malo bolje razmislite, mi smo suštinski pronašli način da nateramo pesak da misli. To je čudesno.
Razmere uticaja ove tehnologije biće bez presedana, možda deset puta veće od Industrijske revolucije, i to deset puta većom brzinom. Pomoći će nam da rešimo neke od najvećih problema sa kojima se društvo suočava — od ubrzanja otkrivanja novih lekova, preko razvoja novih izvora čiste energije, do kreiranja potpuno novih naprednih materijala. Mogli bismo čak dospeti do tačke u kojoj resursi više neće predstavljati ograničavajući faktor za ljudski napredak, što bi nas uvelo u neverovatnu novu eru blagostanja.
Izazovi na samom čelu razvoja
AI već počinje da donosi realne koristi u praksi, ali da bismo ostvarili njen ogromni potencijal, moramo promišljeno i pažljivo navigirati kroz ovaj kritični period razvoja. Hitno je potrebna akcija kako bismo se suočili sa rizicima koji se mogu javiti kako se budemo približavali AGI-ju.
Već smo uočili izazove koje napredni (“frontier”) modeli donose na polju sajber-bezbednosti, a sa daljim napretkom sposobnosti ubrzo se mogu pojaviti i druge pretnje, uključujući nuklearne i biološke rizike. Na horizontu nas čeka potreba za robusnim zaštitnim mehanizmima (“safeguards”) kako bismo zadržali kontrolu nad sistemima koji su sve više agencijalni (“agentic”) i koji se rekurzivno samousavršavaju — ali i za rešavanjem nepoznatih problema koji će postajati jasniji tek s vremenom.
Oduvek sam verovao u snagu ljudske domišljatosti i kreativnosti u rešavanju bilo kog problema. Uveren sam da je ublažavanje tehničkih rizika povezanih sa AI-jem izazov na koji možemo zajednički odgovoriti, ali samo ako sebi damo dovoljno vremena i prostora da ovaj sledeći, ključni korak uradimo kako treba. Trenutno, kao naučna zajednica i kao šire društvo, mi to ne radimo.
U ovom trenutku, zaključani smo u izuzetno intenzivnoj, višeslojnoj komercijalnoj i geopolitičkoj trci. Iako ova takmičarska dinamika podstiče brz napredak i ubrzava neverovatne pozitivne strane, napredak na samom čelu razvoja prevazilazi naše razumevanje tehnologije. Niko na svetu ne zna sa sigurnošću šta će se odavde nadalje dešavati, pa se čak ni stručnjaci ne slažu.
Kada postoji visok stepen neodređenosti, a ulozi su ovako visoki, nastupanje sa opreznim optimizmom jeste jedina razumna i ispravna strategija. To zahteva javne politike koje promovišu inovacije, ali istovremeno podstiču odgovornost i bezbednost, neguju međunarodnu saradnju na ključnim pitanjima sigurnosti i podstiču pažljivo razmatranje načina na koji se AI primenjuje za dobrobit društva.
Okvir za telo za standarde u oblasti napredne AI
Brzi napredak kom svedočimo zahteva nov pristup testiranju sposobnosti naprednih AI modela (“frontier AI models”) koji je dinamičan, prilagodljiv i rigorozan. Sjedinjene Američke Države se, s obzirom na svoj ekonomski i tehnološki položaj, nalaze u dobroj poziciji da naprave prvi korak u razvoju takvog okvira. one bi mogle da osnuju novo Telo za standarde (“Standards Body”) oblikovano po uzoru na javno-privatno partnerstvo pod federalnim nadzorom ili samoregulatornu organizaciju — nalik Regulatornom telu za finansijsku industriju (FINRA) — sa upravnim odborom u kom bi sedeli nezavisni vodeći tehnički stručnjaci i predstavnici open-source zajednice.
Finansiranje bi moralo da bude znatno i verovatno bi većim delom dolazilo iz industrije, kako bi se privukli vrhunski tehnički talenti i obezbedili neophodni računarski resursi (“compute resources”) za testiranja velikih razmera.
Telo za standarde bilo bi odgovorno za razvoj protokola za procenu i saradnju sa odgovarajućim federalnim agencijama i nacionalnim laboratorijama SAD radi sprovođenja testiranja u oblastima od značaja za nacionalnu bezbednost. Model bi se kvalifikovao kao model napredne klase (“Frontier-class”) ukoliko ispuni određene pragove na setu benchmark testova koje određuje Telo za standarde, a koji bi se redovno ažurirali kako bi pratili razvoj AI sposobnosti. Organizacije sa “naprednim modelima” (Frontier Models), kako je definisano tim benchmark testovima, smatrale bi se naprednim laboratorijama (“Frontier Labs”) i bile bi podstaknute da usvoje najbolje prakse — kao što su objavljivanje tehničkih kartica modela (“model cards”) sa tehničkim detaljima, održavanje visoke unutrašnje sajber-bezbednosti, provera ključnog osoblja, obezbeđivanje dovoljnih resursa za istraživanje sigurnosti i bezbednosti, i drugo.
U početku, napredne laboratorije bi dobrovoljno delile modele sa Telom za standarde radi procene do 30 dana pre zvaničnog objavljivanja. Kada se pokaže da je protokol procene delotvoran i robustan, ubrzo bi moglo uslediti njegovo formalizovanje, što znači da bi napredni modeli morali da ga prođu kako bi mogli da budu plasirani na tržište SAD. Laboratorije bi takođe sarađivale sa Telom za standarde na otklanjanju svih kritičnih ranjivosti uočenih nakon objavljivanja.
Procene modela trebalo bi da obuhvate rigorozne naučne evaluacije sposobnosti u domenima sajber-bezbednosti, bioloških pretnji i drugih visokorizičnih oblasti. Specifični testovi za agencijalnu AI (“agentic AI”) mogli bi da ispituju pokušaje zaobilaženja sigurnosnih zaštitnih ograda (“safety guardrails”) ili znake obmane, kao i da obezbede primenu najboljih praksi — poput digitalnog vodenog žiga na AI-generisanim slikama i generisanja izlaznih tokena u formatu čitljivom za ljude, kako bi se razumelo rasuđivanje modela.
Ove evaluacije bi se redovno ažurirale, u početku možda kvartalno, pri čemu bi se zastareli ili zasićeni benchmark testovi odbacivali i zamenjivali novim. U prvoj fazi, razvijali bi se u konsultaciji sa naprednim laboratorijama, ali bi s vremenom Telo za standarde trebalo da izgradi sopstvene tehničke kapacitete za kreiranje nezavisnih, tajnih testova (“held-out tests”) izvan laboratorija, kako bi se sprečilo prilagođavanje modela konkretnim testovima (“overfitting”). U saradnji sa vladom SAD, ono bi moglo da promoviše ekosistem eksternih revizora (“third-party auditors”) koji bi pomagali u procenama i razvoju novih benchmarka i evaluacija.
Snaga ovog pristupa leži u tome što bi bio tehnički usmeren, dok bi istovremeno podržavao inovacije i podsticao odgovorno ponašanje. Koncipiran je tako da prati ubrzanje u ovoj oblasti i da se prilagođava najvećim rizicima kako se oni budu identifikovali, a mogao bi se i poostriti ukoliko ozbiljnost situacije to bude zahtevala — uključujući i koordinaciju usporavanja razvoja među naprednim laboratorijama ako se to proceni neophodnim.
Sticanje statusa napredne laboratorije nosilo bi značajan prestiž i bilo bi otvoreno za svaku organizaciju koja napravi modele koji ispunjavaju benchmark kriterijume. Ovaj okvir bi se primenjivao na modele napredne klase bez obzira na njihovu zemlju porekla ili na to da li su otvorenog ili zatvorenog tipa (“open or closed”), dok bi svi ostali modeli koji ne spadaju u tu klasu — na primer oni koje razvijaju startapi ili akademska zajednica — bili izuzeti iz ovog procesa.
Ovaj napor koji pokreću SAD pružio bi snažnu polaznu tačku za uspostavljanje zajedničkih međunarodnih standarda za naprednu AI. Budući da će ova tehnologija uticati na čitavu planetu, idealno bi bilo da ovaj okvir podstakne međunarodnu zajednicu na postizanje konsenzusa o upravljanju najozbiljnijim rizicima, uz obezbeđivanje da svako ima pristup i mogućnost da iskoristi prilike koje AI donosi.
Budućnost još nije napisana
AGI ima potencijal da postane vrhunski alat za napredak nauke i medicine, kao i da podstakne ogroman rast produktivnosti i ekonomski razvoj. Ali da bismo to postigli, moramo postaviti prave tehničke temelje — koordinacijom oko zajedničkog globalnog okvira, primenom najrigoroznijih naučnih metoda i okupljanjem najboljih umova na rešavanju izazova sa kojima se suočavamo.
Čak i ako rešimo ove teške tehničke izazove, ostaće kompleksna ekonomska i filozofska pitanja na koja treba odgovoriti:
Kakvi će novi ekonomski modeli biti potrebni kako bi svi napredovali u svetu nakon oskudice (“post-scarcity world”)?
Kojim vrednostima želimo da se vodimo, šta će predstavljati smisao i svrhu, i na koji način se može promeniti i samo ljudsko stanje?
Rešavanje ovih pitanja očigledno ne može i ne treba da bude prepušteno samo tehnolozima. Ono zahteva da se svaki deo društva okupi i pomogne u definisanju ovog novog poglavlja.
Oko AI-ja postoji i veliko uzbuđenje i nesigurnost, i oba su sa razlogom prisutna. Ali budućnost još nije napisana — moramo iskoristiti ovaj dragoceni trenutak pre dolaska AGI-ja da oblikujemo ovu tehnologiju na dobrobit čitavog čovečanstva. Ono što kolektivno uradimo sada odrediće kako će se odvijati sledeća faza civilizacije. Bezbednim uvođenjem AGI-ja u svet možemo ući u novo zlatno doba naučnih otkrića i napretka i zakoračiti u svetlu budućnost neverovatnog ljudskog procvata.